Die Forschung der Gruppe „Systematische Proteomik & Bioanalytik“ stützt sich auf zwei Säulen:
1
Methodenentwicklung für die MS-basierte Proteomik und die proteoformorientierte Proteomik (Bottom-up-Proteomik (BUP), Middle-down-Proteomik (MDP), Top-down-Proteomik (TDP), N-/C-Terminomik, Low-Input-Proteomik (LIP)). Die Methodenentwicklung umfasst die gesamte analytische Pipeline, angefangen bei der Probenvorbereitung über LC- und CE-Trennsysteme bis hin zur massenspektrometrischen Detektion und Charakterisierung von Peptiden, Proteinen und Proteomen.
2
Anwendung dieser Methoden auf biomedizinische, biologische und biotechnologische Forschungsfragen.
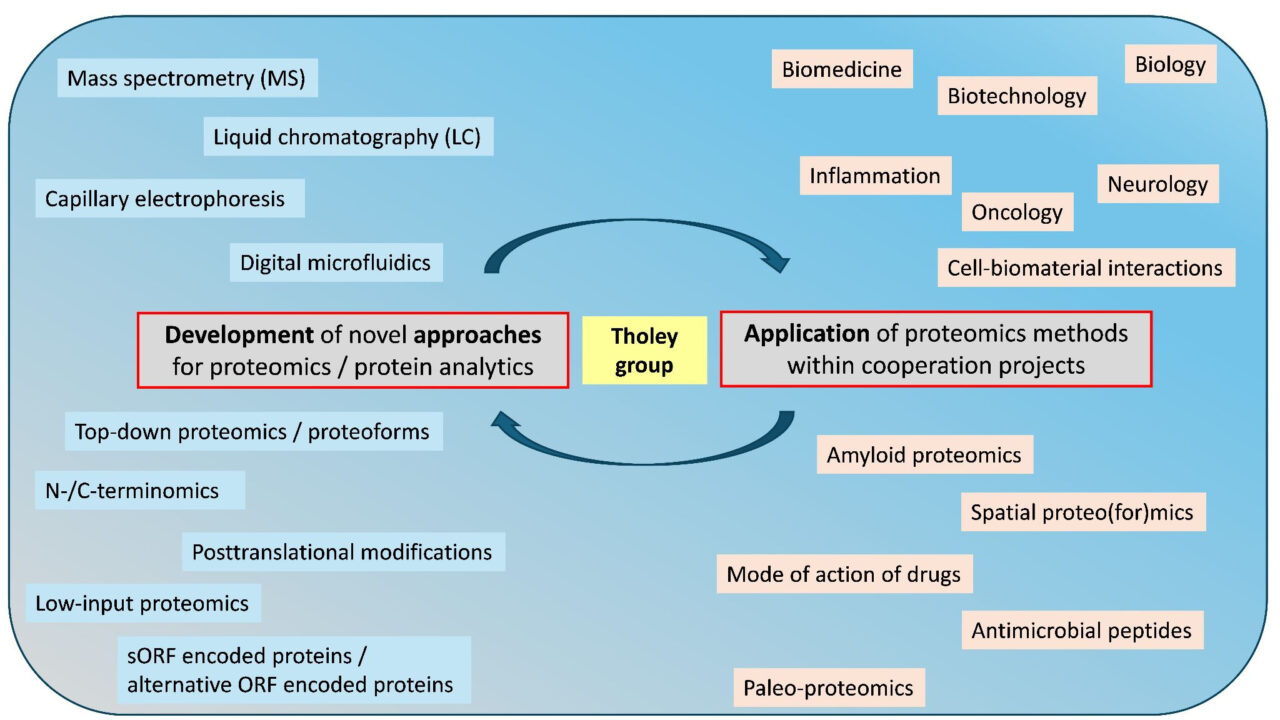
Die beiden Säulen sind eng miteinander verknüpft; so werden analytische Entwicklungen durch die Anforderungen der Anwendungsprojekte vorangetrieben, und neu entwickelte analytische Ansätze fließen wiederum in die Projekte zurück, wodurch diesen Methoden auf dem neuesten Stand der Technik zur Verfügung gestellt werden können.
Anfragen zur ZUSAMMENARBEIT:
Unsere Gruppe ist nicht als zentrale Einrichtung oder Dienstleistungseinheit organisiert, sondern fungiert als forschungsorientierte bioanalytische Plattform, die neuartige Analysetechnologien entwickelt und diese zusammen mit etablierten Methoden in Kooperationsprojekten einsetzt.
Wir sind jederzeit offen für Kooperationen! Falls Sie Proteomik-Experimente durchführen möchten, wenden Sie sich bitte per E-Mail an Prof. A. Tholey.
Was können wir für Kooperationsprojekte anbieten?
- Proteinidentifizierung in Zelllysaten, Überständen, Körperflüssigkeiten, Geweben und Gewebeschnitten.
- Quantitative Analysen: Ermittlung von Veränderungen der Proteinkonzentrationen unter verschiedenen biologischen Bedingungen.
- Identifizierung posttranslationaler Modifikationen (z. B. Phosphorylierung, Acetylierung/Lipidierung, Oxidation (einschließlich Disulfidbrücken), Glykosylierung, Modifikation durch (reaktive) Metaboliten und viele weitere).
- N- und C-Terminomik
- Proteomik mit geringem Probenbedarf: Analyse von Proben, die beispielsweise aus einer geringen Zellanzahl (unter 50 Zellen) stammen.
- Identifizierung von Protein-Protein-Wechselwirkungen.
- Proteomweite Identifizierung proteolytischer Prozesse.
- Charakterisierung einzelner Proteine, z. B. Antikörper, Antikörper-Wirkstoff-Konjugate usw.
(Viel) mehr auf Anfrage – wir besprechen Ihre analytische Fragestellung gerne mit Ihnen!
Unsere Forschung: Analyse von Proteoformen!
Die Proteinbiosynthese beginnt mit dem Transkriptionsprozess, bei dem aus der genomischen Information mRNA-Transkripte erzeugt werden; anschließend erfolgt die Translation des Polynukleotids auf Proteinebene. Darüber hinaus wurden kürzlich alternative Start- und Stoppcodons beschrieben, die den Raum der genetischen Information erweitern und letztlich zur Bildung alternativer Proteine (altProt) führen.
In beiden Phasen der Proteinbiosynthese können zahlreiche biologische Prozesse ablaufen, die die endgültigen Proteinprodukte gegenüber der genetisch kodierten Information verändern. Während auf Transkript-Ebene alternatives Spleißen zu unterschiedlichen mRNAs führen kann, was schließlich zur Bildung von Proteinisoformen (Abbildung 1) führt, können auf Proteinebene chemische Modifikationen sowohl während (co-translational) als auch nach der Translation (posttranslationale Modifikationen, PTMs) auftreten. Zu letzteren Ereignissen gehören sowohl kovalente Modifikationen der Aminosäure-Seitenketten – von denen bisher mehr als 300 beschrieben wurden – als auch die proteolytische Verarbeitung (z. B. Trunkierung) der Peptidkette. Infolgedessen entsteht aus einer gegebenen Anzahl von Genen eine exponentiell größere Anzahl verschiedener Proteinmoleküle (Spezies); diese Proteinspezies werden als Proteoformen bezeichnet.
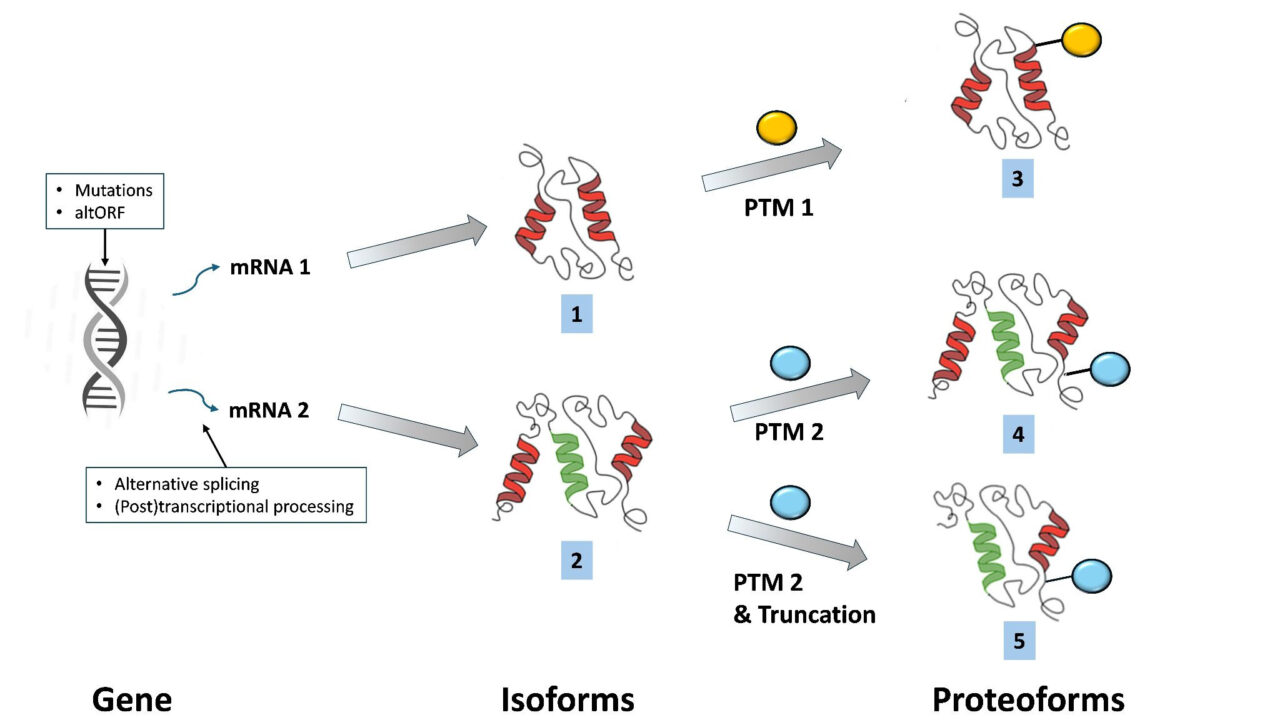
Abbildung 1: Entstehung von Proteoformen. Aus einem einzigen Gen können über verschiedene Wege bei der Transkription (z. B. alternatives Spleißen) unterschiedliche Isoformen entstehen. Die weitere Verarbeitung während oder nach der Translation (ko- oder posttranslationale Modifikationen) führt zur Bildung von Proteinspezies (= Proteoformen), die sich in ihrer molekularen Zusammensetzung, ihren physikalisch-chemischen Eigenschaften und ihrer Struktur unterscheiden. Proteoformen eines bestimmten Gens können daher völlig unterschiedliche biologische Funktionen haben oder sogar an unterschiedlichen biologischen Prozessen beteiligt sein. Das macht Proteoformen zur eigentlichen „aktiven Währung“ des Lebens! Die Anzahl der Proteoformen beim Menschen lässt sich nur schätzen (im obigen Beispiel sind es fünf verschiedene PrF aus einem Gen), wobei aktuelle Schätzungen von ca. 6 Mio. bis zu mehr als 1 Milliarde verschiedener Proteoformen reichen, die aus nur ca. 22.500 Genen gebildet werden. Da die Anzahl der kodierenden Sequenzen derzeit aufgrund der Identifizierung kurzer offener Leserahmen (z. B. für Mikroproteine) und alternativer offener Leserahmen stark zunimmt – wobei deren Genprodukte zudem posttranslationale Modifikationen durchlaufen –, wird die Anzahl der Proteoformen in Zellen noch weiter steigen.
Durch die Veränderung der Aminosäure-Seitenketten oder der Länge des Peptidrückgrats weisen verschiedene Proteoformen, die aus einer einzigen kodierten Proteinsequenz entstehen, unterschiedliche physikalisch-chemische Eigenschaften wie Molekularmasse, Nettoladung oder Hydrophobie auf. Diese Eigenschaften beeinflussen die Proteinfaltung und bestimmen letztlich die Struktur der Proteoformen. Da die Struktur und die physikalisch-chemischen Eigenschaften die Proteinfunktion bestimmen, können verschiedene Proteoformen eines bestimmten Proteins unterschiedliche molekulare Funktionen haben und an völlig unterschiedlichen biologischen Prozessen beteiligt sein. Proteoformen eines bestimmten Proteins können sich in ihrer subzellulären Lokalisierung und ihren Interaktionspartnern unterscheiden und modifizierte (z. B. Enzymkinetik) oder völlig andere biologische Aktivitäten aufweisen.
Daher ist die Kenntnis der Proteoformen innerhalb eines biologischen Systems unerlässlich, um die molekularen Prozesse zu verstehen, die die Biologie antreiben. Da sich diese Informationen weder aus genomischen noch aus transkriptomischen Daten ableiten lassen, sind proteomische Technologien erforderlich, um Proteoformen in komplexen biologischen Umgebungen zu identifizieren, zu quantifizieren und zu charakterisieren und so ihre Rolle in biologischen Prozessen aufzuklären.
Derzeit ist die Bottom-up-Proteomik (BUP) der vorherrschende Ansatz in der Proteomanalyse. Der Bottom-up-Arbeitsablauf umfasst den proteolytischen Abbau von Proteinen in Peptide unter Verwendung einer aktiven Protease, gefolgt von der Trennung des komplexen Peptidgemischs, z. B. mittels Flüssigchromatographie (LC), und einer massenspektrometrischen (MS) Analyse zur Bestimmung der Peptidmassen und zur Ableitung von Peptidsequenzinformationen (MS/MS). Ein entscheidender Schritt bei der BUP ist die Ableitung von Informationen auf Proteinebene aus den Peptiddaten. Dieser Prozess, die Proteinkonjektur, ermöglicht die Identifizierung und Quantifizierung von Proteingruppen; wie jedoch in Abbildung 2 dargestellt, gehen Informationen über die nativen Proteoformen aufgrund des proteolytischen Aufschlusses verloren.
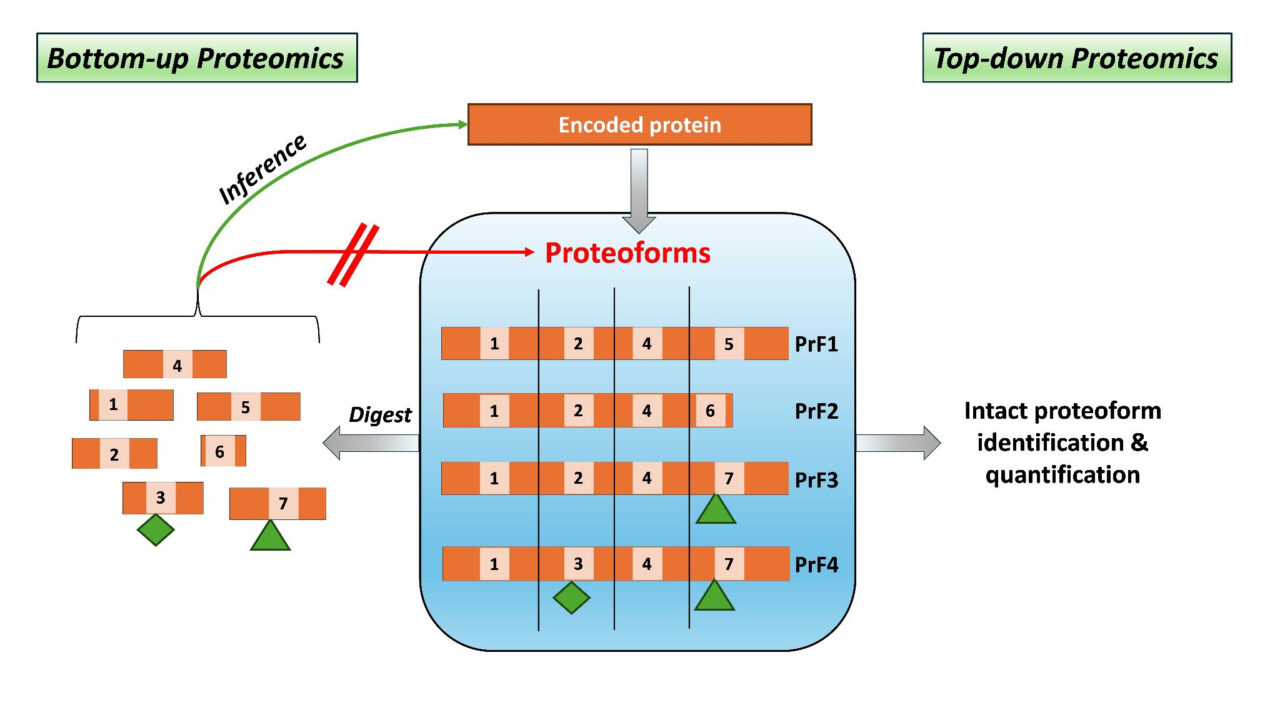
Abbildung 2: BUP (links) im Vergleich zu TDP (rechts). Beim BUP-Ansatz werden alle Proteine/Proteoformen einer Probe verdaut, wodurch eine große Anzahl von Peptiden entsteht (Peptide 1–7; ihre Position in den Proteoformen PrF 1–4 ist im mittleren Kasten dargestellt). Nach der Analyse, hauptsächlich mittels LC-MS/MS, können diese Peptide zur Ableitung des kodierten Proteins herangezogen werden. Es ist jedoch nicht möglich, die genaue PrF, aus der ein bestimmtes Peptid stammt, eindeutig zuzuordnen. Im Gegensatz dazu zielt TDP auf die direkte Identifizierung der PrF ab, wodurch alle Informationen über eine bestimmte Proteoform (z. B. Seitenkettenmodifikationen, Verkürzungen und insbesondere die Kombination dieser Modifikationen in einer bestimmten PrF) erhalten bleiben. Auch bei TDP ist LC-MS/MS der vorherrschende Ansatz, allerdings werden dabei sowohl für die Trennung als auch für die MS-Analyse unterschiedliche analytische Parameter verwendet.
Zwar ist die BUP eine etablierte und empfindliche Technologie, doch der Verlust von Informationen auf Proteoform-Ebene macht alternative analytische Ansätze erforderlich. Die Top-down-Proteomik (TDP) schließt diese Lücke. Bei der TDP erfolgt die Analyse auf der Ebene intakter Proteine, wodurch a priori alle Informationen über eine Proteoform innerhalb eines einzelnen Moleküls erhalten bleiben. Zwar ist die direkte Analyse intakter Proteine anstelle von verdauten Peptiden intuitiv, doch haben zahlreiche analytische Herausforderungen in der Vergangenheit den breiten Einsatz dieser Technologie verhindert. Wesentliche Herausforderungen, von denen hier nur eine Auswahl aufgeführt ist, treten auf allen Ebenen der analytischen Pipeline auf: (1) Probenvorbereitung: verminderte Löslichkeit intakter Proteine, wenn sie aus ihrer zellulären Umgebung freigesetzt werden; (2) die Trennung intakter Proteine mittels LC ist weniger unkompliziert als die von Peptiden; (3) MS und MS/MS: geringere Empfindlichkeiten, z. B. aufgrund der breiten Ladungszustandsverteilung bei der Elektronenspray-Ionisation (ESI)-MS; die Notwendigkeit effizienter, aber dennoch fehleranfälliger Dekonvolutionsalgorithmen; die Notwendigkeit hochauflösender MS-Geräte; sehr komplexe MS/MS-Spektren, oft mit unvollständigen Ionenreihen; (4) Dateninterpretation: Fehlen von Algorithmen zur Datenintegration; Fehlen definierter Kriterien zur Datenkuratierung (z. B. Falsch-Entdeckungsraten). Die Bewältigung dieser Herausforderungen im Bereich TDP ist ein Hauptziel unserer Forschung.
Proteolytische Verarbeitung oder alternative Start-/Stoppcodons können zur Bildung verkürzter Proteoformen oder von Proteoformen mit nicht-kanonischen N- oder C-Termini führen. Für die proteomweite Identifizierung von N- und C-Termini wurden N- und C-Terminomik-Ansätze entwickelt, die hauptsächlich auf BUP basieren. Demgegenüber identifiziert TDP a priori die intakte Proteoform und damit beide Termini in einer gegebenen Proteoform. Unsere Gruppe arbeitet an der Verbesserung von BUP-basierten Terminomik-Ansätzen und an der Integration mit TDP (integrative mehrstufige Proteoformik).
Anwendungsorientierte Projekte (Beispiele)
- Peptide, die von kurzen offenen Leserahmen kodiert werden (SEP), Mikroproteine und Proteine, die von alternativen ORFs kodiert werden (altProt).
- Antimikrobielle Peptide.
- Amyloid-Proteomik.
- Untersuchungen zum Wirkmechanismus neuer Arzneimittel: Identifizierung von Zielmolekülen und Off-Targets auf Proteoform-Ebene.
- Räumliche Proteomik.
- Immunpeptidomik.
- Paläoproteomik.
Gruppenleitung
-
Prof. Dr. Andreas Tholey
Arbeitsgruppenleitung+49 (0)431 500 – 30300
Team
-
Christian Treitz
Post-Doktorand*in+49 (0)431 500 – 30352
-
Philipp Kaulich
Post-Doktorand*in+49 (0)431 500 – 30355
-
Liam Cassidy
Post-Doktorand*in+49 (0)431 500 – 30353
-
Patrick Kaleja
Post-Doktorand*in+49 (0)431 500 – 30352
-
Theo Matzanke
Doktorand*in+49 (0)431 500 – 30355
-
Marie Skott
Doktorand*in -
N. N.
Technische*r Mitarbeiter*in -
Josefine Rost
Master Student*in -
Linus Schustakowski
Master Student*in -
Luisa Meiert
+49 (0) 431- 30353
-
Handan Müftüoglu
Assistenz
Publikationen
-
Molecular & Cellular Proteomics
·
Properties, Origin, and Consistency of Truncated Proteoforms Across Top-Down Proteomic Studies
Kaulich PT, Fulcher JM, Tholey A
-
Proteomics
·
Top-Down Proteomics: Why and When?
Kaulich PT, Tholey A
-
Nature Methods
·
Influence of different sample preparation approaches on proteoform identification by top-down proteomics
Kaulich PT, Jeong K, Kohlbacher O, Tholey A
-
Angewandte Chemie International Edition
·
Digital Microfluidics and Magnetic Bead-Based Intact Proteoform Elution for Quantitative Top-down Nanoproteomics of Single C. elegans Nematodes
Leipert J, Kaulich PT, Steinbach MK, Steer B, Winkels K, Blurton C, Leippe M, Tholey A
-
iScience
·
Proteoforms expand the world of microproteins and short open reading frame-encoded peptides
Cassidy L, Kaulich PT, Tholey A